Как выбрать ИИ-модель в 2026 году: сравнение GLM-5.3, GPT, Claude, DeepSeek, Kimi и Qwen
Большой обзор нейросетей для программирования, создания контента, аналитики, автоматизации и работы с ИИ-агентами. Актуально на октябрь 2026 года.
Рынок искусственного интеллекта развивается настолько быстро, что выбор нейросети становится отдельной задачей. Ещё недавно пользователи сравнивали преимущественно ChatGPT и Claude. Теперь серьёзную конкуренцию им составляют китайские разработки GLM, DeepSeek, Kimi и Qwen, а открытые модели всё чаще показывают результаты, сопоставимые с коммерческими решениями.
При этом понятие «лучшая нейросеть» постепенно теряет смысл. Одна модель отлично пишет программный код, другая лучше справляется с аналитикой, третья эффективнее управляет инструментами, а четвёртая позволяет обрабатывать большие объёмы информации с минимальными затратами.
Показательный пример — выход GLM-5.3 от Z.ai в августе 2026 года. Разработчики не стали создавать новую базовую модель, а значительно улучшили существующую GLM-5.2 посредством дополнительного обучения. В результате нейросеть продемонстрировала существенный рост качества программирования, автономного выполнения задач и анализа уязвимостей.
На примере GLM-5.3 и её конкурентов разберём, как объективно сравнивать современные языковые модели, что означают результаты тестов и какую нейросеть выбрать под конкретные задачи.
Почему нельзя выбрать лучшую нейросеть по одному рейтингу
Большинство рейтингов ИИ-моделей строится на результатах бенчмарков — специальных тестов, которые оценивают способности искусственного интеллекта.
Однако высокий результат в одном тесте не гарантирует превосходства в остальных.
Например, нейросеть может отлично решать алгоритмические задачи, но допускать ошибки при редактировании существующего проекта. Другая модель способна создавать качественный код, однако плохо справляется с поиском ошибок в большой кодовой базе.
Есть и менее очевидные различия. Некоторые модели демонстрируют высокую точность, но расходуют значительно больше токенов. Другие работают быстрее и дешевле, хотя уступают в сложных рассуждениях.
Поэтому выбирать модель нужно по нескольким критериям:
-
Качество ответов. Насколько правильно модель решает задачи и соблюдает инструкции.
-
Программирование. Может ли она не только генерировать код, но и исправлять ошибки, работать с репозиториями и запускать тесты.
-
Агентные возможности. Умеет ли модель самостоятельно планировать действия и использовать внешние инструменты.
-
Контекстное окно. Сколько информации можно передать нейросети в одном запросе.
-
Скорость. Как быстро модель начинает отвечать и генерирует результат.
-
Стоимость. Сколько стоит обработка входящих и исходящих токенов.
-
Открытость. Можно ли самостоятельно развернуть модель на собственном оборудовании.
-
Безопасность. Насколько предсказуемо модель выполняет инструкции и работает с конфиденциальной информацией.
Для повседневного общения достаточно качественной универсальной модели. Для разработки сложного приложения или автономного ИИ-агента требования будут существенно выше.
GLM-5.3: почему эта модель привлекла внимание разработчиков
14 августа 2026 года компания Z.ai представила GLM-5.3 — языковую модель, ориентированную прежде всего на сложное программирование, многоэтапные задачи и автономную работу с инструментами.
Главная особенность релиза заключается в том, что GLM-5.3 использует ту же базовую модель, что и GLM-5.2. Разработчики сосредоточились на post-training — дополнительном обучении после основного этапа подготовки модели.
Это важное изменение подхода. Оно показывает, что качество нейросети определяется не только количеством параметров или объёмом исходных обучающих данных. Огромное значение имеет то, как модель обучают выполнять реальные задачи.
По данным Z.ai, новая версия продемонстрировала примерно 50-процентный относительный прирост качества в собственном тесте Z.ai Code Bench. Особенно заметно улучшились результаты при работе со сложными программными проектами и длительными последовательностями действий.
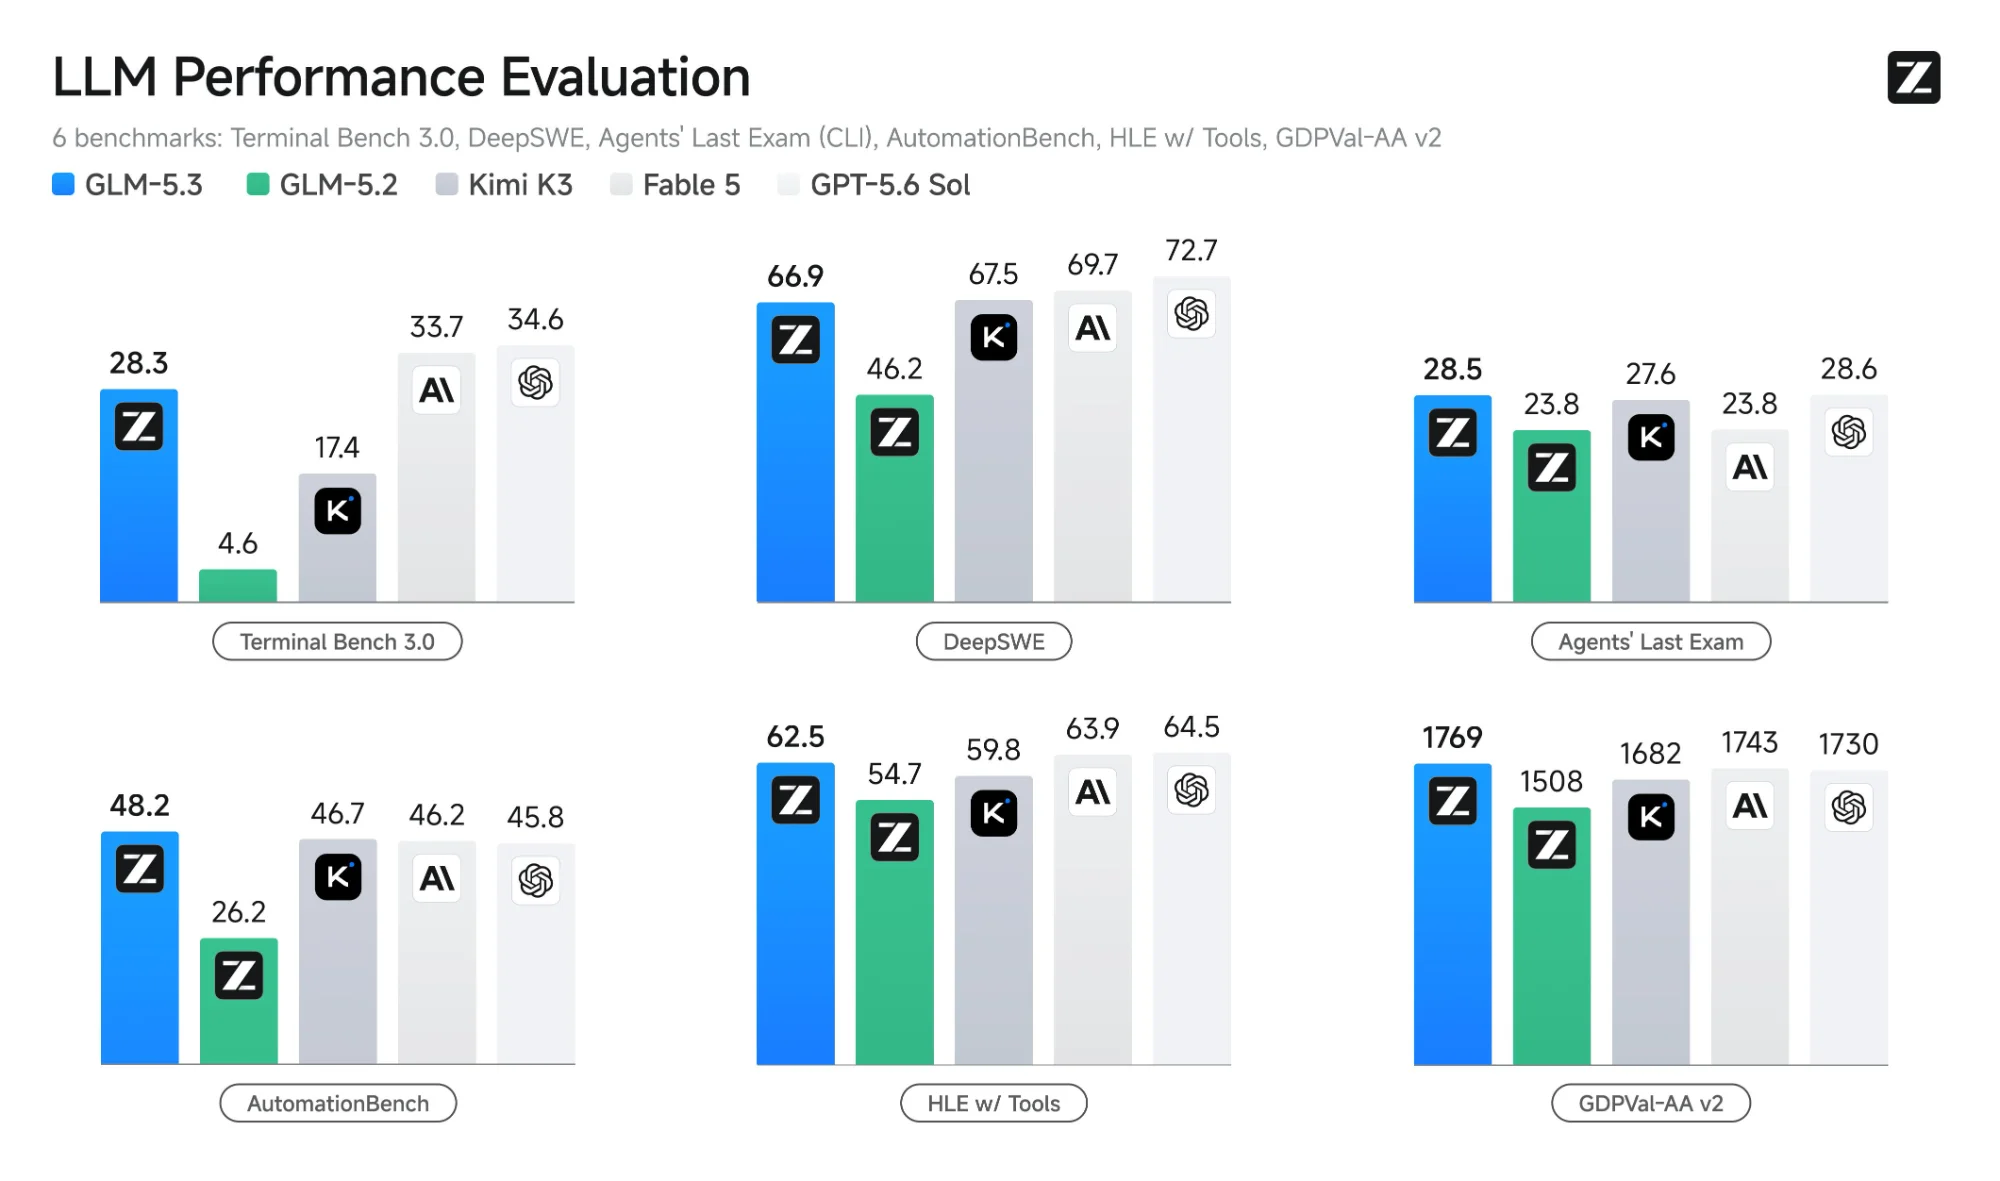
Особенно интересен результат Terminal Bench 3.0. Если предыдущая версия набирала 4,6 балла, то новая достигла 28,3. Это более чем шестикратное увеличение показателя.
Подобные изменения означают, что модель стала значительно лучше справляться с задачами, требующими последовательного взаимодействия с терминалом и рабочим окружением.
Например, вместо генерации отдельного фрагмента кода нейросеть может получить задачу изучить проект, найти причину ошибки, внести исправления и проверить результат.
Но важно понимать: рост результатов тестирования не означает, что GLM-5.3 стала в шесть раз лучше во всех сценариях. Улучшение относится к конкретному тесту и его методике.
Сравнение GLM-5.3 с GPT, Claude, DeepSeek, Kimi и Qwen
Разработчики Z.ai опубликовали сравнительную таблицу с результатами нескольких ведущих моделей.
В неё вошли GLM-5.3, GLM-5.2, Kimi K3, DeepSeek-V4 Pro, Qwen3.8-Max, Claude Opus 4.8 и GPT-5.6 Sol.
Для объективного анализа важно смотреть не на общий рекламный рейтинг, а на отдельные категории тестирования.
Результаты программирования
Чем выше показатель, тем лучше. Данные опубликованы Z.ai в августе 2026 года.
|
Модель |
Terminal Bench 2.1 |
DeepSWE v1.1 |
|---|---|---|
|
GPT-5.6 Sol |
88,8 |
72,7 |
|
GLM-5.3 |
88,2 |
66,9 |
|
Kimi K3 |
88,3 |
67,5 |
|
DeepSeek-V4 Pro |
87,9 |
62,7 |
|
Qwen3.8-Max |
86,6 |
56,6 |
|
Claude Opus 4.8 |
85,0 |
58,0 |
|
GLM-5.2 |
81,0 |
46,2 |
Из таблицы видно, что GLM-5.3 приблизилась к наиболее сильным коммерческим моделям в отдельных задачах программирования.
При этом GPT-5.6 Sol сохраняет преимущество в обоих приведённых тестах. Kimi K3 также демонстрирует очень близкие результаты, а в DeepSWE немного опережает GLM-5.3.
Здесь есть важный нюанс: разница в несколько десятых балла не обязательно означает заметную разницу в реальной работе. На практике результат может зависеть от сложности проекта, используемых инструментов, системного промпта и числа попыток решения.
Поэтому таблица полезна для предварительного выбора, но не заменяет собственное тестирование.
Какую модель выбрать для программирования
Для разработчиков современные ИИ-модели становятся не просто генераторами кода, а полноценными помощниками, способными работать с существующими проектами.
Например, при разработке интернет-магазина нейросети можно поручить создание новой системы фильтрации товаров. Задача может включать изучение структуры базы данных, написание серверной логики, обновление интерфейса и тестирование.
В подобных сценариях важны три характеристики: способность понимать архитектуру проекта, корректно изменять существующий код и доводить работу до результата.
GLM-5.3 для сложных проектов
GLM-5.3 выглядит особенно интересной для разработчиков, использующих ИИ-агентов.
Модель ориентирована на задачи, в которых требуется выполнять несколько взаимосвязанных действий. Она подходит для работы с крупными репозиториями, рефакторинга, отладки и автоматизации разработки.
Важное преимущество — возможность использовать её через инструменты, поддерживающие совместимые API, включая Claude Code, OpenCode и ZCode.
В опубликованном сравнении Z.ai модель на высоком уровне вычислительных усилий достигла 31,4% успешного выполнения задач в собственном Code Bench при расходе около 50 тысяч выходных токенов. Claude Opus 4.8 в том же сравнении показала 29,5%, используя около 120 тысяч токенов.
Это говорит не только о качестве, но и о потенциальной эффективности использования вычислительных ресурсов.
Однако такие результаты получены в тестовой среде разработчика. Для производственных проектов необходимо дополнительно оценивать число ошибок, стабильность изменений и стоимость полного выполнения задачи.
Когда выбирать GPT
Модели GPT целесообразно рассматривать для сложных инженерных задач, где требуется сочетание программирования, анализа требований, архитектурных решений и работы с инструментами.
В приведённых тестах GPT-5.6 Sol опережает GLM-5.3 по DeepSWE и Terminal Bench 2.1.
При этом конкретная эффективность зависит от выбранной версии модели и используемой среды разработки.
Когда выбирать Claude
Claude остаётся важным вариантом для работы с большими программными проектами, последовательного редактирования файлов и анализа архитектуры.
Однако выбирать Claude только по репутации было бы неправильно. Результаты GLM-5.3 показывают, что открытые модели способны конкурировать с коммерческими решениями, а иногда превосходить их в отдельных тестах.
Когда рассматривать DeepSeek, Kimi и Qwen
Эти модели особенно интересны разработчикам, которые хотят сравнить стоимость и качество работы разных поставщиков.
DeepSeek можно тестировать на задачах генерации кода и логического анализа. Kimi K3 демонстрирует сильные результаты в программных бенчмарках, а Qwen представляет альтернативную экосистему для интеграции в приложения.
Универсального победителя среди них нет. Оптимальная модель определяется конкретной нагрузкой.
ИИ-агенты: почему автономность становится важнее качества отдельных ответов
Одно из наиболее перспективных направлений развития искусственного интеллекта — агентные системы.
Обычный чат-бот получает вопрос и формирует ответ. ИИ-агент может самостоятельно планировать последовательность действий, обращаться к API, выполнять команды, анализировать результаты и продолжать работу.
Например, агенту можно поручить:
-
Получить список товаров из CMS.
-
Найти карточки с отсутствующими описаниями.
-
Сгенерировать новые тексты.
-
Проверить их на соответствие заданной структуре.
-
Отправить данные через API.
-
Сформировать отчёт о выполненной работе.
Для такого сценария недостаточно просто хорошо писать текст. Модель должна корректно вызывать инструменты, сохранять контекст и обрабатывать ошибки.
Сравнение агентных возможностей
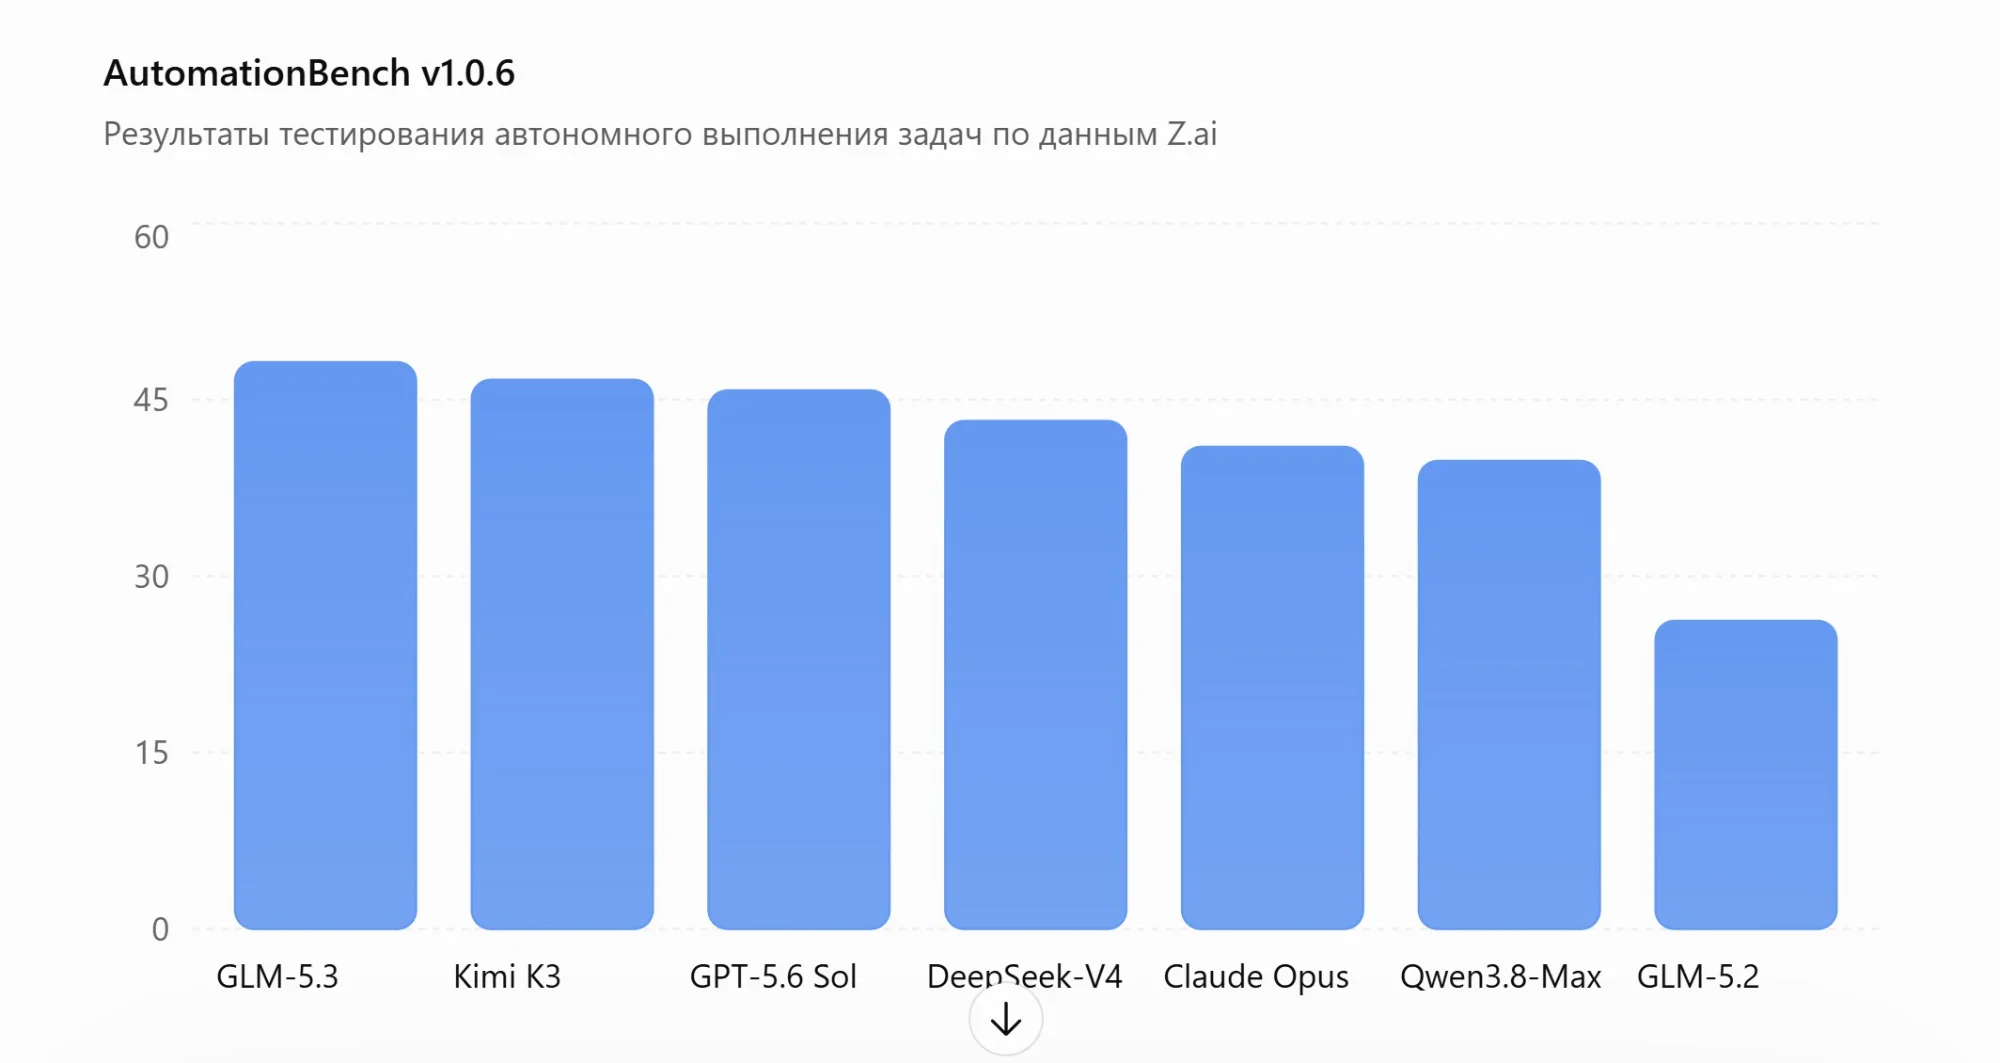
GLM-5.3 показывает лучший результат среди перечисленных моделей в AutomationBench.
Это особенно интересно для систем автоматизации, построенных на n8n, собственных API и агентных фреймворках.
Однако перед внедрением модели в реальную систему важно проверить её поведение при ошибках API, неполных данных и нестандартных ответах инструментов.
В автономных сценариях надёжность иногда важнее максимального результата в бенчмарке. Агент, который правильно выполняет 95% действий, но ошибочно удаляет данные в оставшихся случаях, может быть непригоден для производственного использования без дополнительных ограничений.
GLM-5.3 и кибербезопасность: неожиданный результат обучения
Отдельного внимания заслуживают способности GLM-5.3 в области информационной безопасности.
В процессе дополнительного обучения разработчики включили задачи, связанные с обнаружением программных уязвимостей. По их данным, модель стала значительно лучше не только находить отдельные ошибки, но и анализировать сложные цепочки эксплуатации.
На тесте CyberGym GLM-5.3 набрала 84,5%, превысив результат GLM-5.2, который составлял 77,2%.
На ExploitBench показатель вырос с 24,4 до 54,4. Это более чем двукратное увеличение результата.
Такие способности могут быть полезны при защитном аудите программного обеспечения, проверке зависимостей и поиске потенциально опасных участков кода.
Z.ai также сообщила об обнаружении 2436 уязвимостей в 269 проектах с участием специалистов по безопасности. При этом обнаруженные проблемы проходят экспертную проверку и процедуру ответственного раскрытия.
Но усиление подобных возможностей создаёт дополнительные риски. 29 октября 2026 года Reuters сообщило о независимых исследованиях, в которых GLM-5.3 продемонстрировала способность выполнять отдельные сложные многоэтапные сценарии кибератак в контролируемой среде.
Для компаний это означает необходимость особенно внимательно ограничивать полномочия автономных агентов. Модель, которой предоставлен доступ к серверам, репозиториям и внутренним системам, должна работать с минимально необходимыми правами, журналированием действий и обязательным подтверждением критических операций.
Контекстное окно: почему миллион токенов не гарантирует качество
Ещё один важный параметр выбора нейросети — размер контекстного окна.
Контекст определяет, какой объём информации модель способна учитывать в рамках одного запроса или последовательности сообщений.
Большое контекстное окно позволяет загружать документацию, программные файлы, длинные отчёты и историю работы агента.
Для GLM-5.3 у отдельных API-провайдеров заявлено контекстное окно до одного миллиона токенов. Например, такую конфигурацию предлагает Mistral.
Но здесь важно различать две вещи: техническую возможность принять большой объём информации и способность правильно использовать все содержащиеся в нём сведения.
Модель может поддерживать миллион токенов, но при этом хуже находить важные детали в середине длинного документа.
Кроме того, большой контекст увеличивает стоимость обработки запроса, если провайдер тарифицирует входящие токены.
Для сложных проектов зачастую эффективнее использовать поиск по документам, RAG или выборочную загрузку нужных файлов, а не передавать всю информацию целиком.
Скорость и стоимость: почему самая мощная модель не всегда выгодна
Представим два сценария.
В первом случае разработчик один раз в день просит нейросеть провести сложный аудит приложения. Во втором — интернет-магазин ежедневно отправляет десятки тысяч запросов на генерацию описаний товаров.
Для первой задачи оправдано использование дорогой и мощной модели. Во втором случае разница в стоимости каждого запроса превращается в существенную статью расходов.
При оценке стоимости необходимо учитывать не только цену входящих токенов, но и объём выходного текста, стоимость рассуждений, кэширование контекста и число повторных попыток.
Например, у Mistral для GLM-5.3 указаны следующие тарифы:
|
Категория |
Цена за 1 млн токенов |
|---|---|
|
Входящие токены |
$1,40 |
|
Кэшированные входящие |
$0,14 |
|
Исходящие токены |
$4,40 |
Предположим, задача требует 100 тысяч входящих и 20 тысяч выходных токенов.
Тогда приблизительная стоимость одного вызова составит:
То есть около 23 центов без учёта дополнительных вызовов, особенностей тарификации и возможного кэширования.
Однако сравнивать модели только по стоимости миллиона токенов неправильно. Более слабая модель может делать больше ошибок и требовать нескольких повторных запросов.
Для объективной оценки лучше рассчитывать стоимость успешно выполненной задачи:
Где \(C_{\text{total}}\) — общие расходы на выполнение тестовых задач, а \(N_{\text{success}}\) — количество успешно завершённых задач.
Именно такой подход позволяет определить, какая модель действительно выгоднее для бизнеса.
GLM-5.3-Flash: альтернатива для массовых задач
В августе Z.ai также представила GLM-5.3-Flash — отдельную модель, ориентированную на повышение эффективности вычислений.
В отличие от GLM-5.3, которая использует базовую модель предыдущего поколения, Flash получила новую архитектуру и собственный процесс предварительного обучения.
Разработчики заявили 320 миллиардов параметров в общей архитектуре, из которых при обработке задействуется около 18 миллиардов.
GLM-5.3-Flash также стала мультимодальной моделью и получила улучшения для обработки длинного контекста. По данным компании, в ряде тестов она превосходит GLM-5.2 при существенно меньшей стоимости выполнения задач.
Это делает её интересной для массовой автоматизации, обработки документов, работы с API и задач, в которых важен баланс между качеством и стоимостью.
Практический подход — использовать более доступную модель по умолчанию, а сложные запросы передавать флагманской.
Например, GLM-5.3-Flash может выполнять первичную классификацию задач и подготовку данных, а GLM-5.3 — сложный анализ и программирование.
Открытые и закрытые модели: что лучше для бизнеса
Существует два основных подхода к использованию современных нейросетей.
Первый — облачные модели, доступные через готовые сервисы и API. Пользователь оплачивает доступ, а инфраструктуру обслуживает поставщик.
Второй — модели с доступными весами, которые можно разворачивать самостоятельно при наличии подходящего оборудования и соблюдении условий лицензии.
GLM-5.3 относится к категории моделей с открытыми весами. Её материалы доступны в экосистеме Z.ai и на Hugging Face.
Самостоятельное размещение предоставляет дополнительные возможности контроля инфраструктуры, обработки данных и настройки производительности.
Однако локальный запуск крупной модели требует значительных вычислительных ресурсов. Для небольших компаний аренда готового API нередко оказывается экономически выгоднее.
Также следует различать открытые веса и полностью открытое программное обеспечение: доступность параметров модели не означает автоматического отсутствия лицензионных ограничений.
Как правильно тестировать ИИ-модели перед внедрением
Официальные рейтинги полезны для составления предварительного списка кандидатов. Но окончательный выбор желательно делать на собственных задачах.
Допустим, компания выбирает нейросеть для автоматизации работы с интернет-магазином.
Для сравнения можно подготовить одинаковый набор из 30–50 задач: создание описаний, исправление ошибок кода, генерация SQL-запросов, анализ логов и работа с API.
Все модели должны получать сопоставимые инструкции и доступ к одинаковым инструментам.
Калькулятор выбора ИИ-модели
Пример собственной системы оценки. Изменяйте баллы моделей по результатам тестов и важность каждого критерия. Исходные оценки условные, не являются результатами независимого тестирования.
Такой подход позволяет отказаться от субъективного выбора по названию бренда.
Для программирования можно увеличить вес правильности результата и работы с инструментами. Для массовой генерации контента — стоимости и скорости. Для автономных агентов — надёжности выполнения инструкций.
При этом желательно учитывать не только средний балл, но и критические ошибки. Модель с высоким итоговым рейтингом может оказаться непригодной, если регулярно нарушает обязательные требования.
Практические рекомендации: какую нейросеть выбрать под разные задачи
|
Задача |
Какие модели протестировать |
|---|---|
|
Сложное программирование |
GPT, GLM-5.3, Claude, Kimi |
|
Разработка ИИ-агентов |
GLM-5.3, GPT, Claude |
|
Массовая обработка данных |
GLM-5.3-Flash, DeepSeek, Qwen |
|
Анализ больших репозиториев |
GLM-5.3, GPT, Claude |
|
Генерация SEO-контента |
GPT, DeepSeek, Qwen, GLM-5.3-Flash |
|
Защитный аудит кода |
GLM-5.3, GPT, Claude |
|
Собственная инфраструктура |
GLM, Qwen и другие модели с доступными весами |
|
Универсальный ИИ-помощник |
GPT, Claude и доступные универсальные модели |
Это не абсолютный рейтинг, а список кандидатов для практического сравнения. Качество русского языка, генерации SEO-текстов и конкретных рабочих сценариев необходимо оценивать отдельно: приведённые бенчмарки Z.ai не позволяют определить победителя во всех этих категориях.
Почему будущее за использованием нескольких моделей
Развитие GLM-5.3 демонстрирует важную тенденцию: искусственный интеллект становится всё более специализированным.
Нет необходимости использовать самую дорогую модель для каждой операции. Во многих случаях выгоднее распределять задачи между несколькими нейросетями.
Например, система автоматизации контента может использовать одну модель для классификации запросов, другую — для написания текста, третью — для проверки качества.
Такой подход позволяет одновременно повышать качество выполнения сложных задач и снижать затраты на простые операции.
Для разработчиков это означает переход от выбора одной универсальной нейросети к проектированию систем, в которых несколько моделей дополняют друг друга.
Заключение
GLM-5.3 стала одним из заметных примеров того, насколько быстро меняется рынок языковых моделей.
Её результаты показывают, что дополнительное обучение способно значительно улучшить возможности нейросети без создания новой базовой архитектуры. Особенно впечатляют достижения в программировании, автономной работе с инструментами и анализе программных уязвимостей.
При этом GLM-5.3 не является безусловным лидером во всех категориях. GPT, Claude, Kimi, DeepSeek и Qwen сохраняют конкурентные преимущества в отдельных задачах.
Главный вывод заключается в том, что выбирать ИИ-модель нужно не по популярности, размеру или месту в общем рейтинге, а по результатам выполнения конкретной работы.
Для сложного программирования важна точность и способность доводить задачу до конца. Для массовой автоматизации — стоимость успешного выполнения. Для ИИ-агентов — надёжность взаимодействия с инструментами. Для бизнеса — безопасность, управляемость и предсказуемость расходов.
В 2026 году наиболее эффективной стратегией становится не поиск единственной лучшей нейросети, а грамотное сочетание нескольких моделей под разные задачи.
Раз в неделю — что нового и какие промокоды работают.
Читайте также
Опубликовано 29 октября 2026 г.